-
Introduction to Parallel Computing_Parallel Programing Models
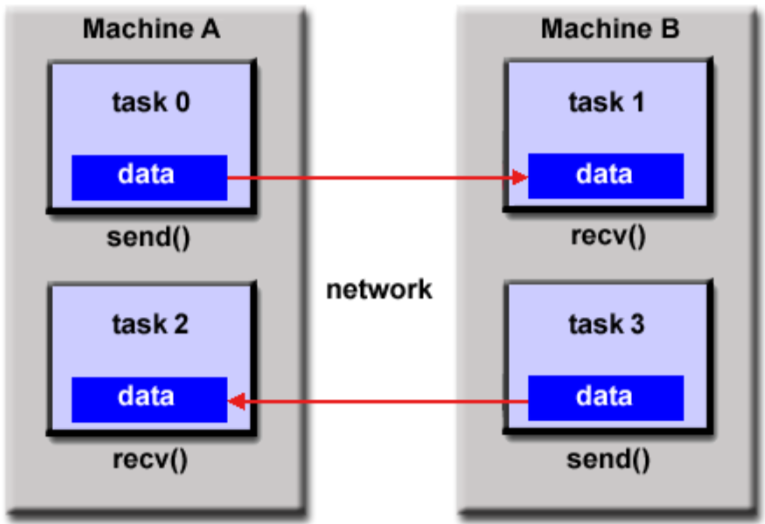
Overview Programming Model 핵심 개념 Shared Memory 여러 Task가 같은 Address Space 사용 Threads 하나의 Process 안에서 여러 실행 흐름 사용 Distributed Memory / Message Passing Task들이 Message를 주고받으며 데이터 교환...
-
Introduction to Parallel Computing_Parallel Computer Memory Architectures
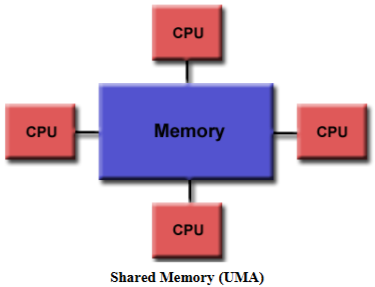
Memory Architecture 핵심 Shared Memory 여러 Processor가 하나의 Global Memory를 공유 Distributed Memory 각 Processor가 자신의 Local Memory를 가짐 Hybrid Shared + Distributed 구조를 함께 사용 Shared Meomry...
-
Introduction to Parallel Computing_Concepts and Terminology
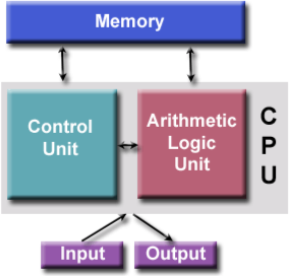
von Neumann Architecture 구성 메모리(Memory), 제어 장치(Control Unit), 산술 논리 장치(Arithmetic Logic Unit), 입출력(Input/Output) Ram 프로그램 명령어와 데이터를 모두 저장하는 데 사용 Program instructio...
-
Introduction to Parallel Computing_Overview
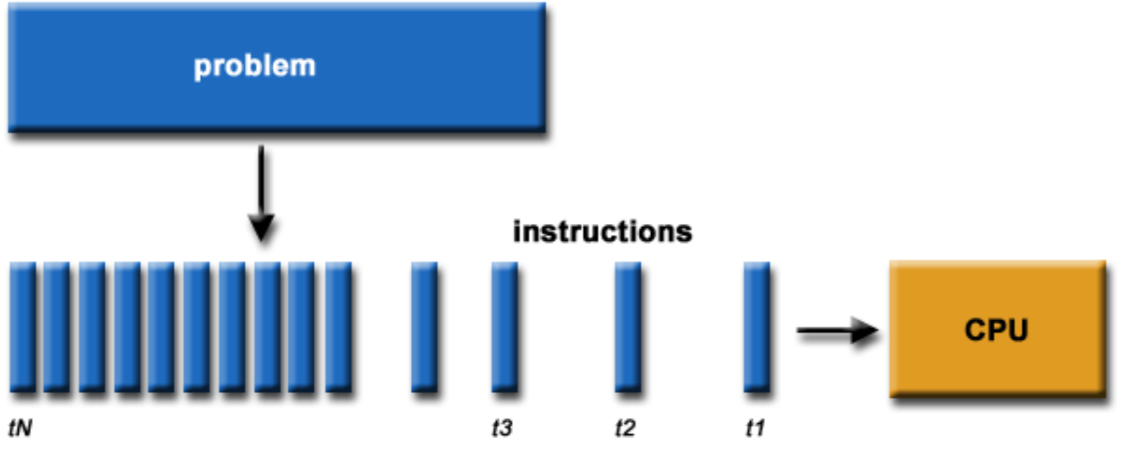
What is Parallel Computing? 기존 cpu 단일 cpu 를 가진 컴퓨터에서 실행되며, Problem은 일련의 개별 명령어들로 분할 후 순차 처리 어느 순간에도 하나의 명령어만 실행됨 병렬 컴퓨팅 Problem은 동시에 해결될 수 있는 개별 부분들로 분할 각 부분은 일련의 ...
-
[논문 리뷰] Deep Learning with Differential Privacy
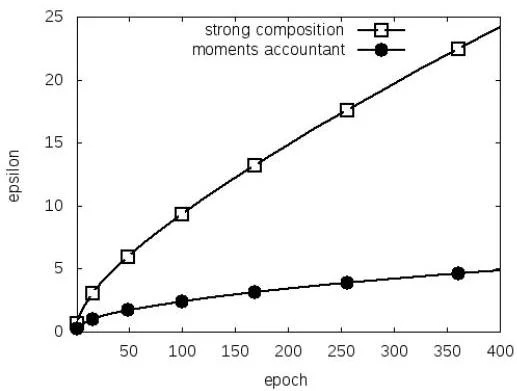
https://arxiv.org/abs/1607.00133 Deep Learning with Differential Privacy Machine learning techniques based on neural networks are achieving remarkable results in a wide v...
-
2.7. NVCC: The NVIDIA CUDA Compiler
nvcc는 CUDA C/C++와 PTX 코드를 컴파일하는 NVIDIA의 Compiler Toolchain CUDA Toolkit에 포함되며 다음 도구를 조정하여 전체 컴파일 과정을 수행 nvcc → Host Compiler → GPU Compiler → Linker → PTX As...
-
2.6. Unified and System Memory
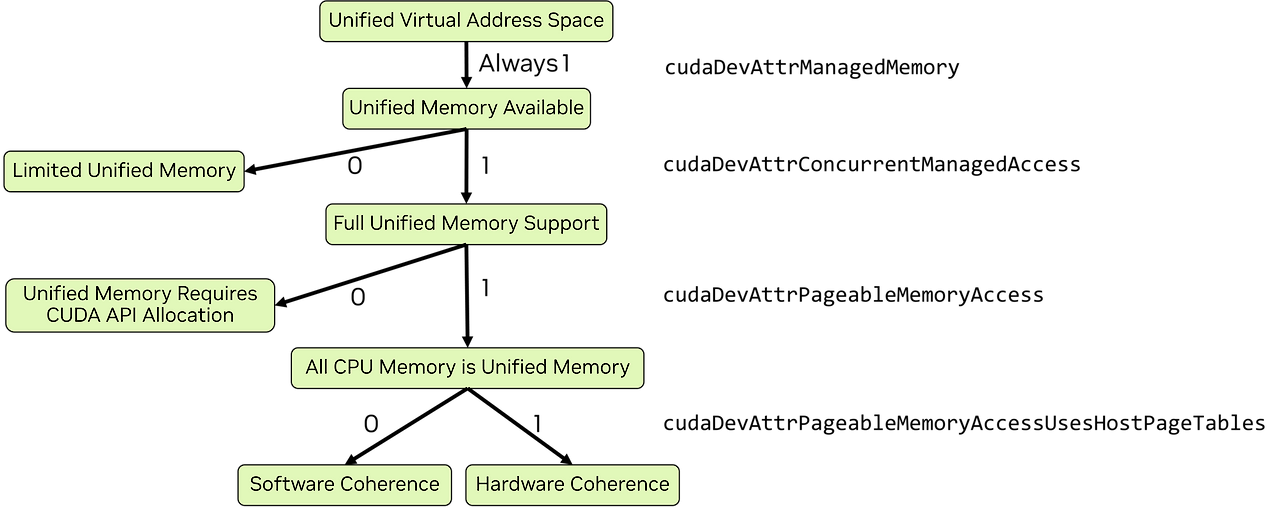
Unified and System Memory CPU와 GPU가 서로 다른 물리 메모리를 사용하는 이기종 시스템에서 메모리 할당, 배치, 이동을 쉽게 관리하기 위한 CUDA 메모리 기능 CPU에는 Host DRAM이 연결되고 각 GPU에는 독립적인 GPU DRAM이 연결됨 CPU → Host DRAM GPU...
-
2.5. Asynchronous Execution
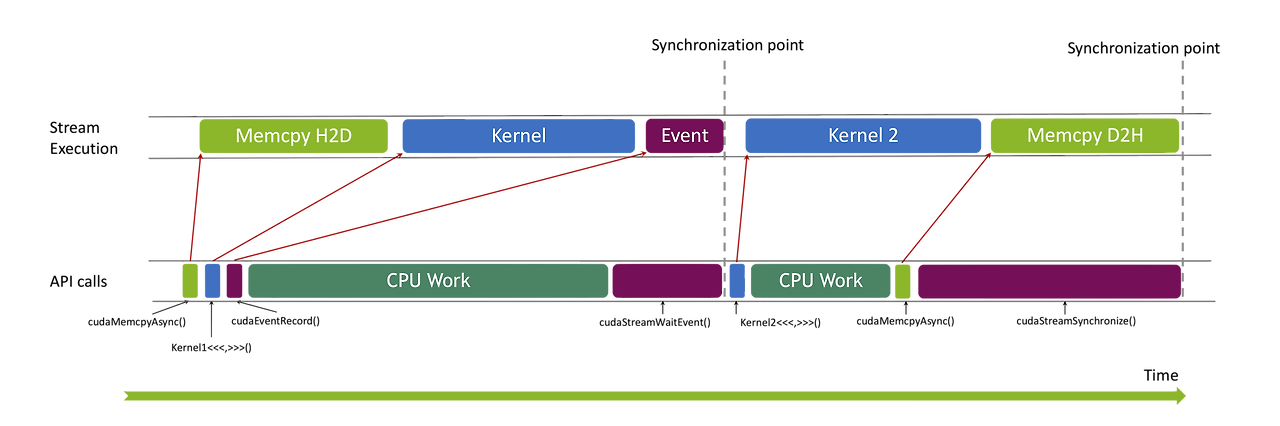
2.5.1. What is Asynchronous Concurrent Execution? CUDA는 여러 작업을 동시에 또는 중복해서 실행할 수 있도록 해주는데 구체적으로는 다음과 같다. 호스트에서의 연산 기기에서의 연산 호스트에서 장치로의 메모리 전송 기기에서 호스트로의 메모리 전송 주어진 장치의 메모리 내에서의 ...
-
[논문 리뷰] Inverting Gradients -- How easy is it to break privacy in federated learning?
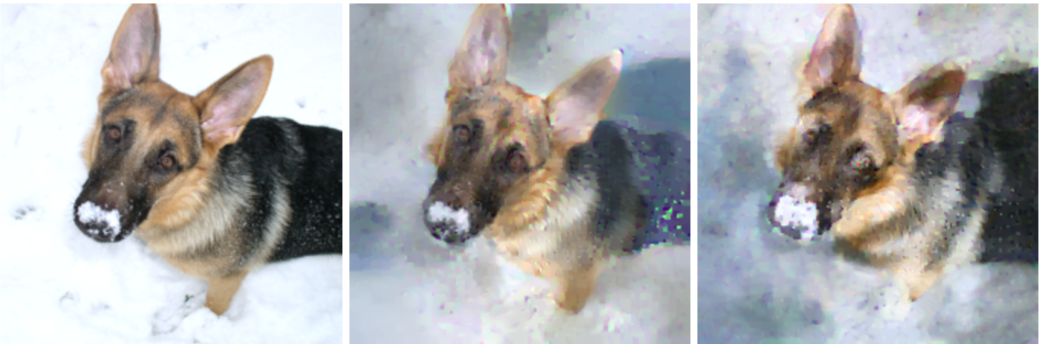
Intro 연합학습은 중앙 집중식 기계 학습에 대한 프라이버시 보호 대안으로 자주 제시된다. 이 패러다임에서 중앙 서버는 전역 모델을 유지하고, 여러 사용자는 로컬 데이터에서 업데이트를 계산하여 모델 훈련에 기여한다. 사용자는 원시적인 민감 정보를 공유하는 대신, 매개변수 기울기($\nabla_\theta L$)만 ...
-
2.4.Writing Tile Kernels
CUDA Tile 은 SIMT모델과는 다른 GPU 커널 코드 작성 방식을 제공 Tile 프로그래밍을 통해 병렬 처리를 다른 방식으로 표현할 수 있고,가장 낮은 수준의 병렬 처리는 컴파일러와 내장 연산에게 맡김 이를 통해 텐서 메모리 가속기(TMA) 장치 및 텐서 코어와 같은 NVIDIA GP...